
[MINICURSO 02] Introduction to Weka: Data Mining with Open Source Machine Learning
Gravado no evento Semana Nacional de Ciência e Tecnologia - IFPI · 4 h 26 min de gravação
Trechos em vídeo
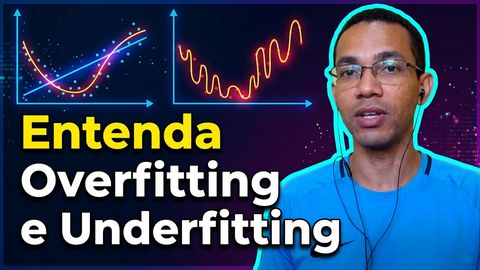
Diferença entre Underfitting, Overfitting e Good Fit
Trecho de a da gravação
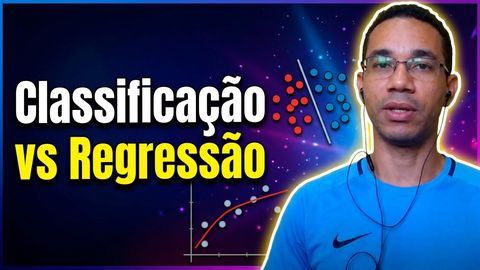
Diferença entre métodos de Classificação e Regressão
Trecho de a da gravação
Como funciona o reconhecimento facial com Machine Learning
Trecho de a da gravação
Sobre o conteúdo
O minicurso "[MINICURSO 02] Introduction to Weka: Data Mining with Open Source Machine Learning", ministrado pelo professor Kelson Carvalho no âmbito da Semana Nacional de Ciência e Tecnologia - IFPI, introduz os conceitos essenciais e as aplicações práticas de mineração de dados e aprendizado de máquina com ferramentas de código aberto.
Inicialmente, o palestrante discute o panorama de Big Data com dados sobre o volume de tráfego online gerado a cada 60 segundos em diversas plataformas sociais, conceituando Ciência de Dados, Mineração de Dados e Aprendizado de Máquina dentro da grande área de Inteligência Artificial. Em seguida, estabelece a distinção entre dados estruturados, não estruturados e combinados, exemplificando a importância dos atributos e instâncias com o clássico conjunto de dados da competição do Titanic no Kaggle.
A apresentação conceitua o aprendizado supervisionado (dividido em classificação e regressão) e o não supervisionado (associação, agrupamento, detecção de desvios, padrões sequenciais e sumarização), além de mencionar o aprendizado por reforço voltado à robótica. Discute-se a relevância do pré-processamento de dados e as armadilhas comuns no treinamento de modelos, como underfitting e overfitting, enfatizando métodos de validação como a divisão percentual e a validação cruzada (cross-validation).
Na etapa prática, o instrutor demonstra a instalação e execução do Weka em ambiente Linux via máquina virtual Java, explorando a interface gráfica Weka Explorer e o formato de arquivo padrão ARFF (Attribute-Relation File Format). Utilizando a base de dados climática weather.nominal.arff, são testados classificadores como Naive Bayes, árvores de decisão (RandomTree) e MultiClassClassifier, analisando métricas de desempenho, matriz de confusão e curvas ROC, além da exportação de modelos treinados.
Por fim, é realizado um experimento com aprendizado não supervisionado utilizando o algoritmo Apriori na aba Associate para a mineração de regras de associação e análise de cesta de compras, demonstrando o ajuste de parâmetros como suporte mínimo, confiança mínima e número de regras antes do encerramento da sessão.
O que é abordado
- Abertura e apresentação pessoal
- Conceitos fundamentais: Big Data, Data Science e Data Mining
- Fundamentos de Machine Learning e aplicaçõesTrecho de 1 min 53 s
- Estrutura dos dados e exemplo do Titanic
- Aprendizagem supervisionada vs. não supervisionada
- Métodos preditivos: classificação e regressãoTrecho de 2 min
- Métodos descritivos e aprendizado por reforço
- Validação de modelos: underfitting, overfitting e good fitTrecho de 1 min 53 s
- Apresentação e download do Weka
- Execução do Weka Explorer e estrutura de arquivos ARFF
- Treinamento, validação e métricas de classificadores
- Mineração de regras de associação com Apriori e encerramento
Dúvidas que o conteúdo responde
O que é o formato de arquivo ARFF utilizado pelo Weka?
O ARFF (Attribute-Relation File Format) é um formato de arquivo texto estruturado próprio do Weka. Ele é composto pelo cabeçalho com o nome da relação (@relation) e a declaração de cada coluna ou atributo (@attribute), seguido pelas linhas de instâncias na seção @data.
Qual a diferença básica entre aprendizado supervisionado e não supervisionado?
No aprendizado supervisionado, o modelo é treinado fornecendo-se as características dos dados acompanhadas de uma classe alvo (target/resposta esperada), aprendendo a mapear entradas para saídas. No aprendizado não supervisionado, não há classe alvo ou resposta pré-definida; o algoritmo busca identificar padrões, agrupamentos ou associações estruturais nos dados por conta própria.
O que causa overfitting no treinamento de um algoritmo de machine learning?
O overfitting ocorre quando o modelo se ajusta excessivamente aos dados de treinamento, decorando ruídos e particularidades em vez de generalizar o padrão. Isso costuma acontecer, por exemplo, quando se avalia o algoritmo com os exatos mesmos dados utilizados para treiná-lo, resultando em acurácia artificialmente alta no treino, mas desempenho ruim com novos dados.
Para que serve a matriz de confusão gerada no Weka?
A matriz de confusão resume o desempenho de um classificador, permitindo visualizar a quantidade de instâncias classificadas corretamente como verdadeiros positivos e verdadeiros negativos, bem como os erros classificados como falsos positivos e falsos negativos.
Assuntos
Palestrantes
Kelson Carvalho
Palestrante